Phân tích nhân tố khám phá (EFA) là bước kiểm tra xem các câu hỏi trong bảng hỏi có gom thành đúng những nhóm mà mô hình nghiên cứu của bạn dự kiến hay không. Trong khóa luận khảo sát, EFA thường chạy sau Cronbach’s Alpha và trước khi kiểm định giả thuyết. Bài này hướng dẫn sáu bước chạy trong SPSS, cách đọc từng bảng kết quả và cách viết vào khóa luận, kèm ví dụ số liệu giả định để bạn thấy dạng kết quả.
Cách chạy EFA khi nào là cần thiết và khi nào không?
Bạn cần EFA khi khóa luận có một bảng hỏi nhiều mục đo nhiều khái niệm, và bạn muốn chứng minh mỗi mục thuộc đúng khái niệm của nó. Bạn có thể không cần EFA khi thang đo chỉ có một khái niệm với ít mục, hoặc khi người hướng dẫn chỉ yêu cầu báo cáo độ tin cậy. Hãy hỏi người hướng dẫn ngay từ đầu để biết khoa yêu cầu mức nào.
Thứ tự phổ biến là: làm sạch dữ liệu, tính độ tin cậy cho từng thang đo (xem bài Cronbach’s Alpha bao nhiêu là đạt), chạy EFA, rồi mới sang tương quan và hồi quy. Bảng thứ tự đầy đủ nằm trong bài chạy kiểm định nào cho khóa luận Marketing. Bài này đi sâu vào riêng bước EFA.
Bước 1. Chuẩn bị dữ liệu trước khi chạy EFA như thế nào?
Ba việc cần làm trước khi bấm chạy.
- Chỉ đưa vào các mục đo bằng cùng một kiểu thang (ví dụ toàn bộ là Likert năm mức). Không trộn biến nhân khẩu học như giới tính hay tuổi vào.
- Đảo điểm các mục ngược và xử lý giá trị thiếu theo cách bạn đã nêu ở chương phương pháp.
- Kiểm tra cỡ mẫu so với số mục. Nhiều giáo trình nêu tỷ lệ tối thiểu số quan sát trên số biến quan sát, thường là năm quan sát cho một biến. Với 20 mục, mẫu từ 100 phiếu trở lên theo tỷ lệ này. Hãy xác nhận tỷ lệ trong giáo trình khoa dùng và ghi nguồn, vì đây là quy ước chứ không phải luật. Cách chọn và tính cỡ mẫu có trong bài chọn mẫu và cỡ mẫu.
Ví dụ (giả định) xuyên suốt bài: bảng hỏi có 20 mục đo bốn khái niệm của một khóa luận về sự hài lòng trong công việc: thu nhập, đồng nghiệp, giám sát và hài lòng chung, mỗi khái niệm năm mục, mẫu 240 phiếu hợp lệ.
Bước 2. Chạy EFA trong SPSS cần chọn những tùy chọn nào?
Đường dẫn: Analyze, Dimension Reduction, Factor. Đưa vào ô Variables toàn bộ 20 mục. Sau đó chỉnh bốn hộp thoại.
- Descriptives: tích «KMO and Bartlett’s test of sphericity» để có hai kiểm định điều kiện.
- Extraction: chọn phương pháp trích. Principal Components là mặc định và được nhiều khóa luận dùng; Principal Axis Factoring thường được ưu tiên khi mục tiêu là khám phá cấu trúc tiềm ẩn. Bạn nêu rõ phương pháp đã chọn và lý do. Tích thêm «Scree plot». Giữ tiêu chí eigenvalue lớn hơn 1 làm điểm xuất phát.
- Rotation: chọn Varimax nếu giả định các nhân tố độc lập, hoặc Promax hay Direct Oblimin nếu cho phép các nhân tố tương quan. Trong khảo sát thái độ và hành vi, các khái niệm thường có tương quan nên cần nêu lý do chọn.
- Options: tích «Sorted by size» và «Suppress small coefficients» để ma trận dễ đọc.
Các phần mềm khác như jamovi hay R cũng chạy được phân tích này; bạn có thể cân nhắc theo bài phần mềm thống kê cho luận văn.
Bước 3. Đọc bảng KMO và Bartlett để biết dữ liệu có phù hợp không
Bảng đầu tiên cho hai kiểm định. Chỉ số KMO (Kaiser-Meyer-Olkin) bắt nguồn từ bài «An Index of Factorial Simplicity» của Henry F. Kaiser, đăng trên Psychometrika năm 1974 (tập 39, số 1, trang 31-36). Giá trị nằm giữa 0 và 1, càng gần 1 càng cho thấy dữ liệu phù hợp để phân tích nhân tố. Nhiều giáo trình trong nước lấy mốc từ 0,5 trở lên để chấp nhận; bạn ghi mốc theo giáo trình khoa quy định.
Kiểm định Bartlett kiểm tra giả thuyết rằng ma trận tương quan là ma trận đơn vị, tức các mục hoàn toàn không tương quan. Bạn muốn bác bỏ giả thuyết này, nghĩa là giá trị Sig. nhỏ hơn mức ý nghĩa bạn đặt (thường 0,05).
Số liệu giả định: KMO là 0,83 và Bartlett có Sig. nhỏ hơn 0,001. Cách đọc: dữ liệu phù hợp để phân tích nhân tố, có thể đi tiếp.
Bước 4. Chọn số nhân tố giữ lại và đọc phương sai trích
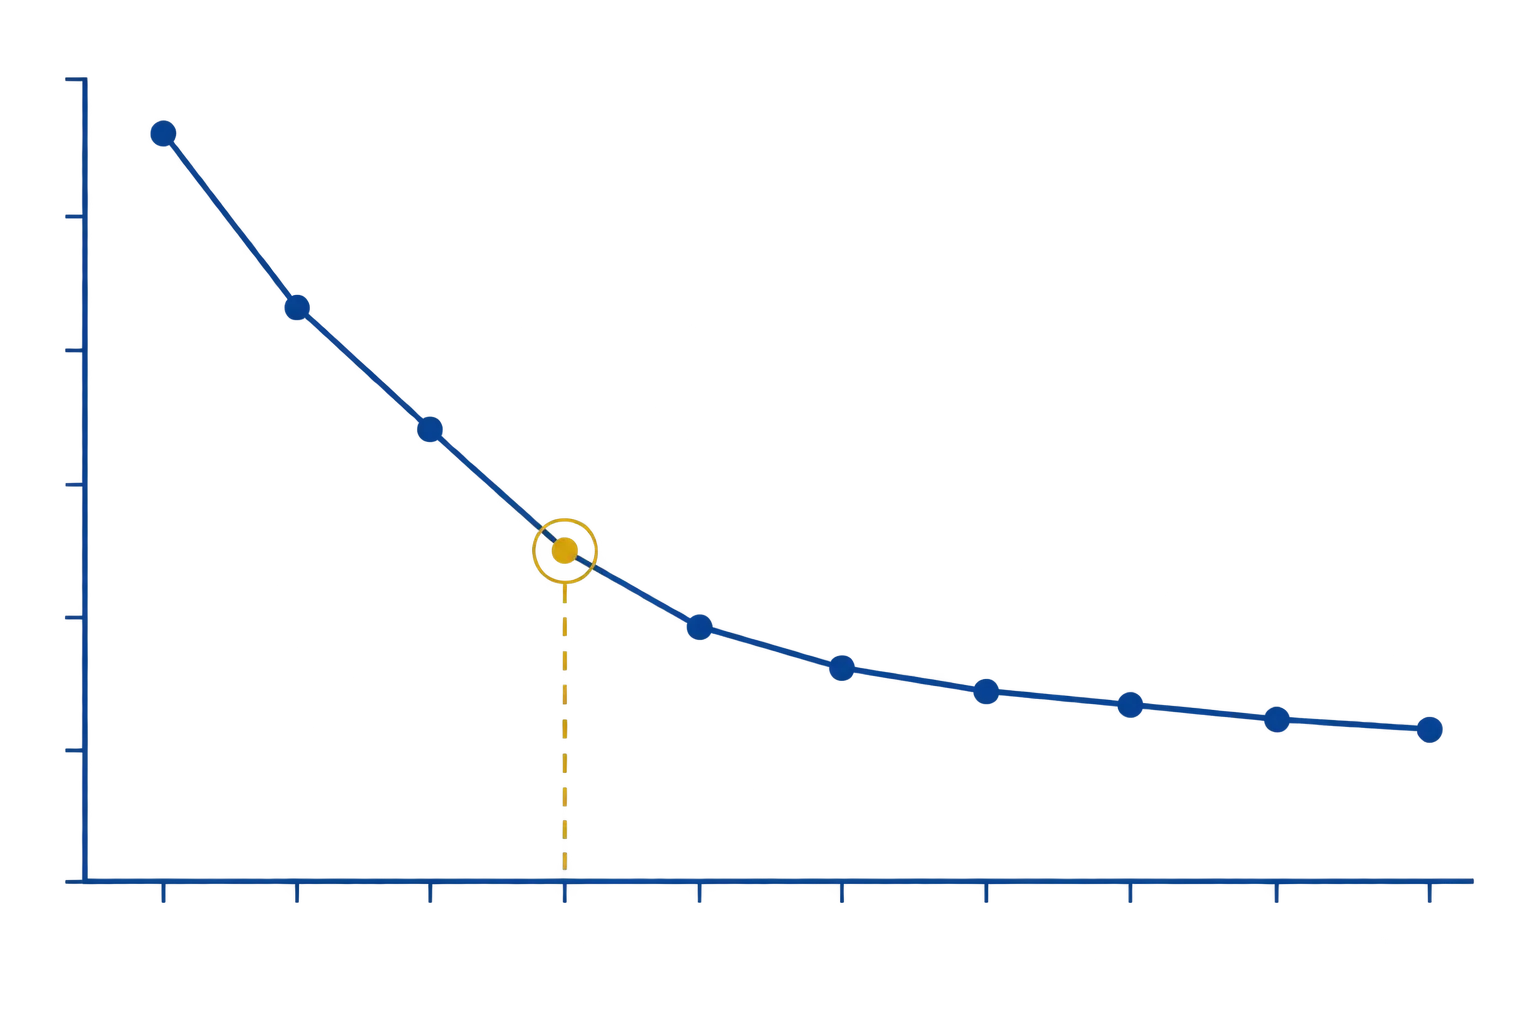
Bảng «Total Variance Explained» cho giá trị riêng (eigenvalue) và phần trăm phương sai mà từng nhân tố giải thích. Hai tiêu chí thường dùng để chọn số nhân tố là eigenvalue lớn hơn 1 và điểm gấp khúc trên scree plot. Hãy đối chiếu cả hai với số khái niệm trong mô hình của bạn.
Số liệu giả định: có bốn nhân tố có eigenvalue lớn hơn 1, tổng phương sai trích là 61,4%. Mô hình dự kiến bốn khái niệm nên kết quả khớp. Nhiều giáo trình nêu mốc tối thiểu cho tổng phương sai trích (thường nhắc 50%); nếu bạn trích dẫn một mốc, hãy ghi giáo trình đã dùng.
Nếu SPSS cho ra số nhân tố nhiều hơn dự kiến, đừng ép về đúng số mô hình. Hãy đọc ma trận xoay ở bước kế tiếp để hiểu vì sao.
Bước 5. Đọc ma trận xoay và hệ số tải nhân tố
Ma trận xoay («Rotated Component Matrix» hay «Pattern Matrix») cho biết mỗi mục tải lên nhân tố nào và mạnh đến đâu. Bạn đọc theo hàng: mỗi mục nên có một hệ số tải rõ ràng trên một nhân tố và thấp ở các nhân tố còn lại.
| Mục (giả định) | Nhân tố 1 | Nhân tố 2 | Nhân tố 3 | Nhân tố 4 |
|---|---|---|---|---|
| TN1 (thu nhập) | 0,81 | 0,10 | 0,08 | 0,12 |
| TN2 (thu nhập) | 0,77 | 0,14 | 0,11 | 0,09 |
| DN1 (đồng nghiệp) | 0,12 | 0,79 | 0,07 | 0,15 |
| GS1 (giám sát) | 0,09 | 0,13 | 0,83 | 0,10 |
| HL4 (hài lòng chung) | 0,16 | 0,48 | 0,11 | 0,52 |
Cách đọc: bốn mục đầu tải rõ ràng lên đúng một nhân tố, đúng như mô hình. Mục HL4 tải lên hai nhân tố với hệ số gần nhau, gọi là tải chéo. Đây là mục cần xem lại, vì nó không phân biệt được giữa hai khái niệm.
Về ngưỡng hệ số tải, nhiều giáo trình nêu mốc 0,5 cho cỡ mẫu vừa phải, và mốc này thay đổi theo cỡ mẫu. Hãy ghi mốc bạn áp dụng cùng nguồn. Khi có mục tải chéo hoặc hệ số tải thấp, cách xử lý đúng như sau.
- Đọc lại nội dung câu hỏi: có hai ý trong một câu không? Có từ dễ hiểu theo nhiều nghĩa không?
- Nếu cần loại, loại từng mục một, bắt đầu từ mục có vấn đề lớn nhất, rồi chạy lại toàn bộ EFA. Đừng loại nhiều mục cùng lúc vì kết quả sẽ thay đổi.
- Sau khi loại, tính lại Cronbach’s Alpha cho thang đo bị ảnh hưởng.
- Ghi lại trong khóa luận mục nào bị loại, vì sao, và kết quả sau khi loại.
Bước 6. Đặt tên nhân tố và viết kết quả vào khóa luận
Khi cấu trúc đã ổn, đặt tên cho từng nhân tố dựa trên nội dung các mục tải lên nó. Nếu nhân tố khớp với khái niệm trong mô hình, giữ tên cũ. Nếu SPSS tách hoặc gộp khác dự kiến, đó là kết quả cần giải thích: nêu rõ nhân tố mới gồm những mục nào, đặt tên mới và điều chỉnh mô hình, giả thuyết cho khớp.
Đoạn viết mẫu (số liệu giả định): «Kiểm định KMO cho kết quả 0,83 và kiểm định Bartlett có ý nghĩa thống kê (Sig. nhỏ hơn 0,001), cho thấy dữ liệu phù hợp để phân tích nhân tố. Với phương pháp trích Principal Components và phép xoay Varimax, có bốn nhân tố có eigenvalue lớn hơn 1, giải thích 61,4% tổng phương sai. Mục HL4 tải chéo lên hai nhân tố nên bị loại; sau khi loại và chạy lại, cấu trúc bốn nhân tố khớp với mô hình đề xuất.» Bảng ma trận xoay đầy đủ đưa vào phụ lục hoặc ngay trong chương kết quả tùy quy định của khoa.
Về cấu trúc chương, phần EFA thường nằm giữa thống kê mô tả, độ tin cậy và kiểm định giả thuyết; bố cục cả chương phương pháp xem ở bài cách viết chương phương pháp nghiên cứu. Nếu khóa luận của bạn dùng mô hình cấu trúc tuyến tính, bước tiếp theo sau EFA thường là phân tích nhân tố khẳng định và kiểm tra giá trị hội tụ, giá trị phân biệt theo tiêu chí của Fornell và Larcker (1981, Journal of Marketing Research, tập 18, số 1, trang 39-50); phần này thường vượt phạm vi khóa luận đại học.
Khi dữ liệu đã chạy xong và bạn cần sắp xếp chương kết quả cho rõ ràng, Tesify giúp bạn sắp xếp và cấu trúc khóa luận của mình: 9,000+ sinh viên đã viết 15,000+ chương với Tesify, và nội dung khóa luận vẫn do chính bạn viết 100%.
Hỏi đáp về phân tích nhân tố khám phá EFA
EFA khác gì Cronbach’s Alpha?
Cronbach’s Alpha đo độ tin cậy nhất quán của một nhóm mục. EFA kiểm tra cấu trúc: các mục có gom thành đúng các nhân tố mà mô hình dự kiến hay không. Hai phép bổ sung cho nhau và thường chạy theo thứ tự alpha trước, EFA sau.
Cần bao nhiêu phiếu để chạy EFA?
Không có một con số chung. Nhiều giáo trình nêu tỷ lệ tối thiểu số quan sát trên số biến quan sát, thường là năm quan sát cho một biến. Hãy kiểm tra giáo trình mà khoa hoặc người hướng dẫn dùng và ghi rõ nguồn.
KMO bao nhiêu là chấp nhận được?
Chỉ số KMO có nguồn gốc từ Kaiser (1974), giá trị càng gần 1 càng cho thấy dữ liệu phù hợp để phân tích nhân tố. Nhiều giáo trình trong nước lấy mốc từ 0,5 trở lên; bạn ghi mốc theo giáo trình khoa quy định.
Nên chọn Principal Components hay Principal Axis Factoring?
Hai phương pháp trích khác nhau về mặt lý thuyết, và nhiều khóa luận dùng Principal Components kèm xoay Varimax. Nếu mục tiêu là khám phá cấu trúc tiềm ẩn thì thường dùng Principal Axis Factoring. Bạn cần nêu phương pháp đã chọn và lý do.
Xoay Varimax hay Promax?
Varimax giả định các nhân tố độc lập với nhau, còn Promax cho phép các nhân tố tương quan. Trong khảo sát hành vi, các khái niệm thường có tương quan nên Promax hợp lý hơn. Khóa luận cần nêu rõ lựa chọn.
Biến bị tải chéo thì xử lý thế nào?
Xem lại nội dung câu hỏi trước. Nếu vẫn tải lên hai nhân tố với hệ số gần nhau, loại từng biến một, chạy lại và ghi vào khóa luận biến nào bị loại, lý do và kết quả sau khi loại.
Có cần chạy EFA nếu dùng thang đo kế thừa?
Thường vẫn nên chạy, vì cấu trúc của thang đo gốc không tự động đúng trên mẫu của bạn. Nếu thang đo chỉ một khía cạnh và ít mục, EFA có thể không cần thiết; hãy hỏi người hướng dẫn.
Nhân tố mới xuất hiện khác với mô hình dự kiến thì sao?
Đó là kết quả cần giải thích, không phải lỗi. Đặt tên nhân tố mới dựa trên nội dung các biến, rồi điều chỉnh mô hình và giả thuyết cho khớp, nêu rõ sự điều chỉnh trong chương kết quả.
EFA có thay thế được phân tích nhân tố khẳng định không?
Không. EFA khám phá cấu trúc, còn phân tích nhân tố khẳng định kiểm tra một cấu trúc đã định trước, thường dùng trong mô hình cấu trúc tuyến tính. Khóa luận đại học thường dừng ở EFA.
Viết kết quả EFA vào chương nào?
Thường ở chương kết quả, sau phần thống kê mô tả và độ tin cậy, trước phần kiểm định giả thuyết. Một số khoa yêu cầu đặt ở chương phương pháp nên hãy theo quy định của khoa.