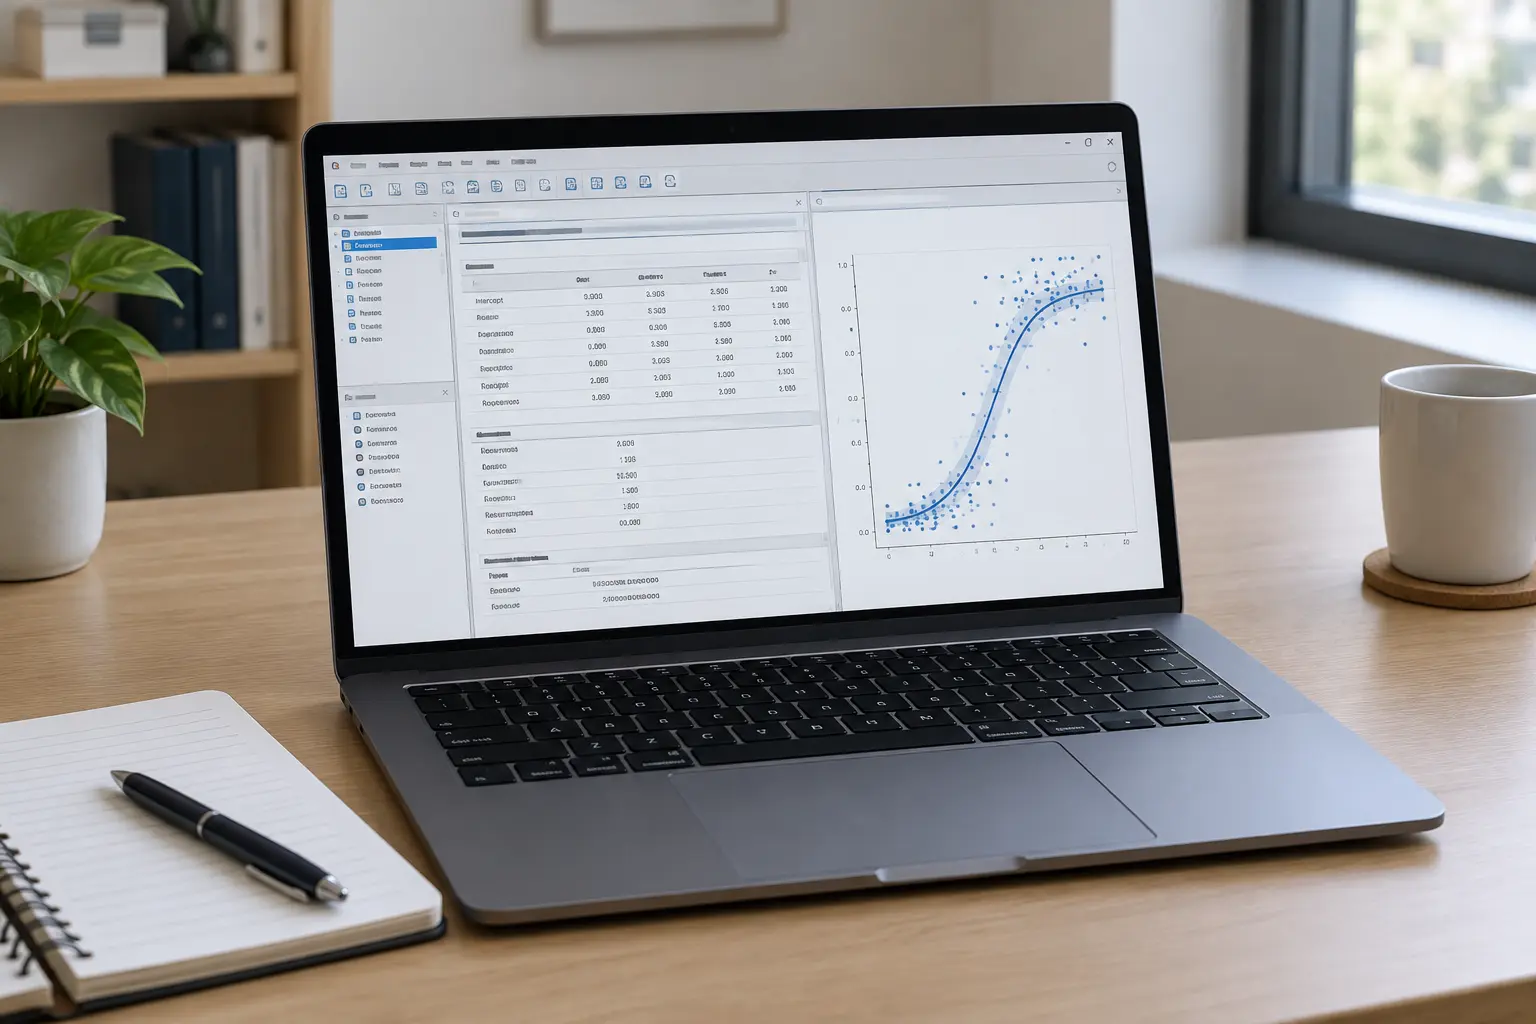
Hồi quy logistic là phép phân tích dùng khi biến phụ thuộc trong khóa luận Y tế công cộng của bạn là biến nhị phân — có/không mắc bệnh, có/không tiêm chủng đầy đủ, có/không bỏ thuốc lá thành công — và bạn muốn biết các yếu tố nào làm tăng hoặc giảm khả năng xảy ra kết cục đó. Bài viết đi từng bước: kiểm tra điều kiện áp dụng, chạy mô hình, đọc kết quả (đặc biệt là tỷ số chênh — odds ratio) và trình bày bảng kết quả đúng chuẩn báo cáo Y tế công cộng.
Nếu bạn chưa xác định xong khách thể và cỡ mẫu cho đề tài, xem trước dân số và cỡ mẫu nghiên cứu trong khóa luận Y tế công cộng — cỡ mẫu đủ lớn là điều kiện tiên quyết để hồi quy logistic cho kết quả ổn định.
Bước 1: Xác định khóa luận của bạn có phù hợp để dùng hồi quy logistic không
Hồi quy logistic phù hợp khi đồng thời có ba điều kiện: (1) biến phụ thuộc là nhị phân (hai giá trị, ví dụ 1 = có bệnh, 0 = không bệnh); (2) các biến độc lập có thể là định lượng hoặc định tính (đã mã hóa); (3) các quan sát độc lập với nhau (không phải dữ liệu đo lặp trên cùng một người mà chưa xử lý bằng mô hình hỗn hợp). Nếu biến phụ thuộc có từ ba giá trị không thứ bậc trở lên, bạn cần hồi quy logistic đa thức (multinomial); nếu có thứ bậc, cần hồi quy logistic thứ bậc (ordinal) — cả hai đều là mở rộng của mô hình nhị phân trình bày trong bài này.
Bước 2: Chuẩn bị dữ liệu và kiểm tra các giả định
Trước khi chạy mô hình, kiểm tra bốn điều: biến phụ thuộc phải mã hóa đúng 0/1 (không phải 1/2); cỡ mẫu đủ lớn — quy tắc kinh nghiệm phổ biến là tối thiểu khoảng 10 quan sát cho mỗi biến độc lập đưa vào mô hình, tính trên nhóm nhỏ hơn của biến phụ thuộc; không có đa cộng tuyến nghiêm trọng giữa các biến độc lập (kiểm tra bằng hệ số VIF, thường lấy ngưỡng dưới 10 làm mốc tham khảo); và không có quan sát ngoại lai có ảnh hưởng quá lớn lên mô hình (kiểm tra bằng khoảng cách Cook hoặc phần dư chuẩn hóa). Nếu bạn cần ôn lại cách chọn mẫu trước bước này, xem chọn mẫu và cỡ mẫu cho luận văn.
Bước 3: Chạy mô hình logistic trong SPSS, R hoặc Stata
Trong SPSS: vào Analyze → Regression → Binary Logistic, đưa biến phụ thuộc vào ô Dependent, các biến độc lập vào ô Covariates, chọn phương pháp Enter (đưa tất cả biến cùng lúc) hoặc Forward/Backward nếu bạn cần chọn biến tự động — nhưng nên ưu tiên Enter và giải thích lý do chọn biến bằng lý thuyết, không để phần mềm tự chọn hộ.
Trong R, câu lệnh cơ bản là glm(ket_cuc ~ bien1 + bien2, data = du_lieu, family = binomial(link = "logit")), sau đó dùng summary() để xem hệ số và exp(coef(mo_hinh)) để đổi hệ số log-odds sang tỷ số chênh (odds ratio) — bước đổi này cần thiết vì hệ số gốc của mô hình logistic khó diễn giải trực quan nếu để nguyên dạng log. Nếu bạn chưa chọn phần mềm thống kê, xem thêm phần mềm thống kê cho luận văn: jamovi, JASP, PSPP, SPSS hay R.
Trong Stata, câu lệnh logistic ket_cuc bien1 bien2 cho kết quả trực tiếp dưới dạng odds ratio, còn logit ket_cuc bien1 bien2 cho hệ số log-odds nếu bạn cần tính thêm.
Bước 4: Đọc và diễn giải tỷ số chênh (odds ratio)
Tỷ số chênh (OR) là con số quan trọng nhất cần đọc đúng: OR = 1 nghĩa là biến đó không liên quan đến kết cục; OR > 1 nghĩa là biến đó đi kèm odds xảy ra kết cục cao hơn; OR < 1 nghĩa là đi kèm odds thấp hơn. Cách diễn giải chuẩn: «odds (tỷ lệ chênh) xảy ra kết cục ở nhóm có đặc điểm X cao gấp OR lần so với nhóm không có đặc điểm X, sau khi đã kiểm soát các biến khác trong mô hình» — luôn kèm khoảng tin cậy 95% (KTC) và giá trị p đi cùng, không báo cáo OR một mình. Tránh viết «khả năng cao gấp OR lần» nếu kết cục không hiếm, vì câu đó ngầm hiểu là tỷ số xác suất (nguy cơ tương đối), không phải tỷ số chênh.
Bước 5: Kiểm tra độ phù hợp của mô hình
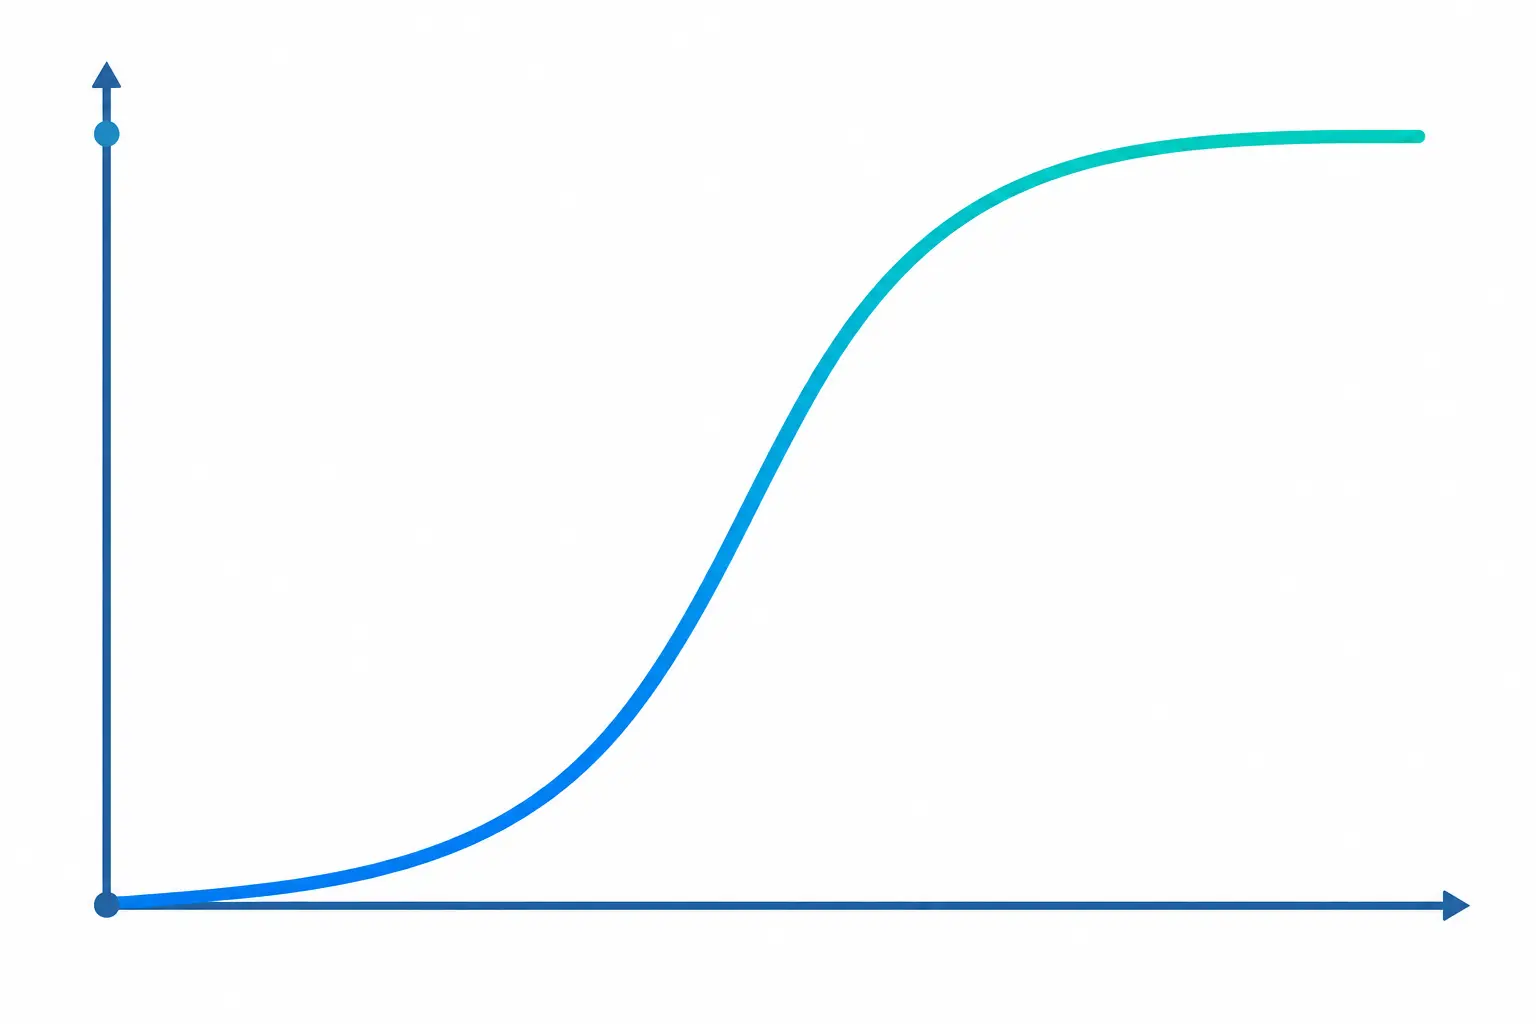
Ba chỉ số thường báo cáo: kiểm định Hosmer-Lemeshow (giá trị p > 0,05 nghĩa là không có bằng chứng mô hình kém phù hợp với dữ liệu — lưu ý đây là trường hợp hiếm khi bạn MUỐN p lớn, ngược với kiểm định giả thuyết thông thường); hệ số Nagelkerke R² (một dạng R² giả lập cho mô hình logistic, không có ý nghĩa giống R² của hồi quy tuyến tính nhưng vẫn được báo cáo như một chỉ số tham khảo); và diện tích dưới đường cong ROC (AUC), với AUC từ khoảng 0,7 trở lên thường được xem là khả năng phân biệt chấp nhận được, và càng gần 1 càng tốt.
Ngoài ba chỉ số trên, nhiều khóa luận Y tế công cộng còn báo cáo thêm bảng phân loại (classification table) với độ nhạy (sensitivity — tỷ lệ mô hình dự đoán đúng nhóm có kết cục) và độ đặc hiệu (specificity — tỷ lệ mô hình dự đoán đúng nhóm không có kết cục) tại ngưỡng xác suất mặc định 0,5. Hai chỉ số này bổ sung cho AUC bằng cách cho thấy mô hình hoạt động tốt đến đâu tại một ngưỡng quyết định cụ thể, thay vì trên toàn bộ dải ngưỡng như AUC.
Bước 6: Trình bày bảng kết quả đúng chuẩn
Bảng kết quả hồi quy logistic trong khóa luận Y tế công cộng thường có các cột: tên biến, hệ số B (log-odds, tùy chọn), sai số chuẩn, tỷ số chênh (OR), khoảng tin cậy 95% của OR, và giá trị p. Mỗi biến một dòng, biến tham chiếu (reference category) của các biến định tính phải được ghi rõ trong chú thích bảng — đây là chi tiết hay bị bỏ sót khiến người đọc không biết OR đang so sánh với nhóm nào.
Ví dụ minh họa (giả định, không phải số liệu thật)
Một khóa luận giả định khảo sát mối liên hệ giữa việc tiêm chủng đầy đủ ở trẻ dưới 2 tuổi (biến phụ thuộc: 1 = tiêm đầy đủ, 0 = chưa đầy đủ) với trình độ học vấn của mẹ và khoảng cách đến trạm y tế gần nhất. Kết quả minh họa: OR của «mẹ có trình độ từ trung học phổ thông trở lên» = 2,4 (KTC 95%: 1,3–4,5; p = 0,006), nghĩa là odds tiêm chủng đầy đủ ở nhóm này cao gấp khoảng 2,4 lần so với nhóm mẹ có trình độ thấp hơn, sau khi kiểm soát khoảng cách đến trạm y tế. Bộ ba số này nhất quán với nhau: ln(2,4) ≈ 0,88; sai số chuẩn suy từ KTC ≈ (ln 4,5 − ln 1,3)/3,92 ≈ 0,32; z ≈ 0,88/0,32 ≈ 2,76, tương ứng p ≈ 0,006 — cách kiểm tra nhanh này giúp bạn phát hiện lỗi chép số trong bảng. Vì tiêm chủng đầy đủ là kết cục phổ biến, không được viết lại thành «khả năng cao gấp 2,4 lần». Đây là số liệu dựng để minh họa cách viết câu diễn giải, không phải kết quả của bất kỳ nghiên cứu thật nào — khi viết khóa luận thật, bạn thay bằng số liệu và địa bàn khảo sát cụ thể của chính đề tài mình (tỉnh hoặc xã nơi bạn thu thập dữ liệu).
Những lỗi thường gặp khi báo cáo hồi quy logistic
Bốn lỗi phổ biến: (1) báo cáo OR mà không kèm khoảng tin cậy 95%, khiến người đọc không biết độ chắc chắn của ước lượng; (2) diễn giải OR như thể là «nguy cơ tương đối» (relative risk) — hai chỉ số này chỉ gần bằng nhau khi kết cục hiếm gặp, còn với kết cục phổ biến (trên khoảng 10%) chúng có thể lệch nhau đáng kể; (3) đưa quá nhiều biến độc lập vào mô hình so với cỡ mẫu, làm hệ số không ổn định; (4) không nêu rõ biến tham chiếu của các biến định tính trong bảng kết quả. Sau khi có bảng kết quả, xem thêm cách viết chương kết quả nghiên cứu và bàn luận để nối kết quả này vào câu chuyện chung của khóa luận.
Con số trong chương kết quả phải là con số thật bạn chạy ra từ SPSS, R hoặc Stata, và câu diễn giải phải do chính bạn viết theo cấu trúc «OR — khoảng tin cậy — giá trị p — ý nghĩa thực tế» ở trên. Tesify đã đồng hành cùng hơn 9.000 sinh viên và hơn 15.000 chương khóa luận, với 100% nội dung do chính người học viết. Bắt đầu soạn khóa luận của bạn với Tesify ngay.
Hỏi đáp nhanh về hồi quy logistic trong khóa luận Y tế công cộng
Hồi quy logistic khác hồi quy tuyến tính ở điểm nào?
Hồi quy tuyến tính dùng khi biến phụ thuộc là biến định lượng liên tục (ví dụ chỉ số BMI); hồi quy logistic dùng khi biến phụ thuộc là biến nhị phân (có/không). Hai mô hình có cách đọc hệ số hoàn toàn khác nhau — tuyến tính đọc trực tiếp, logistic phải đổi sang tỷ số chênh.
Cỡ mẫu bao nhiêu thì đủ để chạy hồi quy logistic?
Không có một con số cố định cho mọi đề tài — quy tắc kinh nghiệm phổ biến nhất là tối thiểu khoảng 10 quan sát cho mỗi biến độc lập, tính trên nhóm nhỏ hơn của biến phụ thuộc; đề tài có nhiều biến độc lập cần cỡ mẫu lớn hơn tương ứng.
Tỷ số chênh (OR) và nguy cơ tương đối (RR) có phải là một không?
Không. OR là tỷ số của tỷ lệ chênh (odds), RR là tỷ số của xác suất (probability) trực tiếp. Hai chỉ số chỉ xấp xỉ bằng nhau khi kết cục hiếm gặp trong quần thể nghiên cứu; với kết cục phổ biến, phải nói rõ là OR chứ không gọi nhầm là RR.
Có bắt buộc phải báo cáo kiểm định Hosmer-Lemeshow không?
Không bắt buộc trong mọi trường hợp, nhưng nên báo cáo khi khóa luận nhấn mạnh vào việc kiểm tra độ phù hợp mô hình; nhiều khóa luận Y tế công cộng thực tế chỉ báo cáo Nagelkerke R² và AUC cũng được chấp nhận, tùy yêu cầu của người hướng dẫn và khoa.
Có thể dùng hồi quy logistic cho dữ liệu thu thập theo cụm (ví dụ theo từng trạm y tế) không?
Có thể, nhưng cần dùng hồi quy logistic đa cấp (multilevel/mixed-effects logistic regression) để tính đến sự phụ thuộc giữa các quan sát trong cùng một cụm, thay vì hồi quy logistic thông thường vốn giả định các quan sát hoàn toàn độc lập.
Phần mềm miễn phí nào chạy được hồi quy logistic?
R (với gói stats có sẵn, hàm glm()) và jamovi (giao diện đồ họa, miễn phí, dựa trên R) đều chạy được hồi quy logistic mà không cần bản quyền trả phí, phù hợp cho khóa luận có ngân sách hạn chế.
Nên đưa bao nhiêu biến độc lập vào mô hình logistic?
Số biến nên được quyết định bằng lý thuyết và khung khái niệm của đề tài trước, sau đó kiểm tra lại bằng quy tắc cỡ mẫu tối thiểu ở trên — không nên đưa tất cả biến có trong bộ dữ liệu vào mô hình chỉ vì có sẵn.
Có cần kiểm tra đa cộng tuyến trước khi chạy hồi quy logistic không?
Có. Đa cộng tuyến nghiêm trọng giữa các biến độc lập làm hệ số ước lượng không ổn định và sai số chuẩn bị phóng đại, dẫn đến kết luận sai về ý nghĩa thống kê của từng biến.
Sau khi có kết quả hồi quy logistic, viết chương bàn luận cần lưu ý gì?
So sánh chiều hướng và độ lớn của OR với các nghiên cứu trước (nếu có), giải thích cơ chế khả dĩ đằng sau mối liên hệ tìm được, và nêu rõ đây là mối liên hệ (association) chứ không phải quan hệ nhân quả (causation) trừ khi thiết kế nghiên cứu của bạn cho phép suy luận nhân quả.